
Ceci est une ancienne révision du document !
Warning: Undefined array key 1 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 172
Warning: Undefined array key 1 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 172
Warning: Undefined array key 1 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 172
Warning: Undefined array key 1 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 172
Warning: Undefined array key 1 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 172
Warning: Undefined array key 1 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 172
Warning: Undefined array key 1 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 172
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Warning: Undefined array key 2 in /home/goupillf/wiki.goupill.fr/lib/plugins/codeprettify/syntax/code.php on line 214
Table des matières
KNN : Exemple des Iris
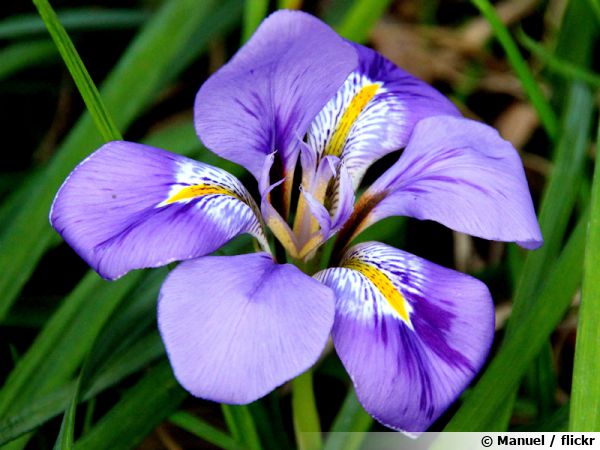
Il s'agit d'un exemple classique.
Les iris (fleurs) se répartissent en différentes espèces : Setosa, Versicolor et Virginica. On voudrait qu'un algorithme puisse décider, si on lui présente une iris, à quelle espèce elle appartient.
Les données
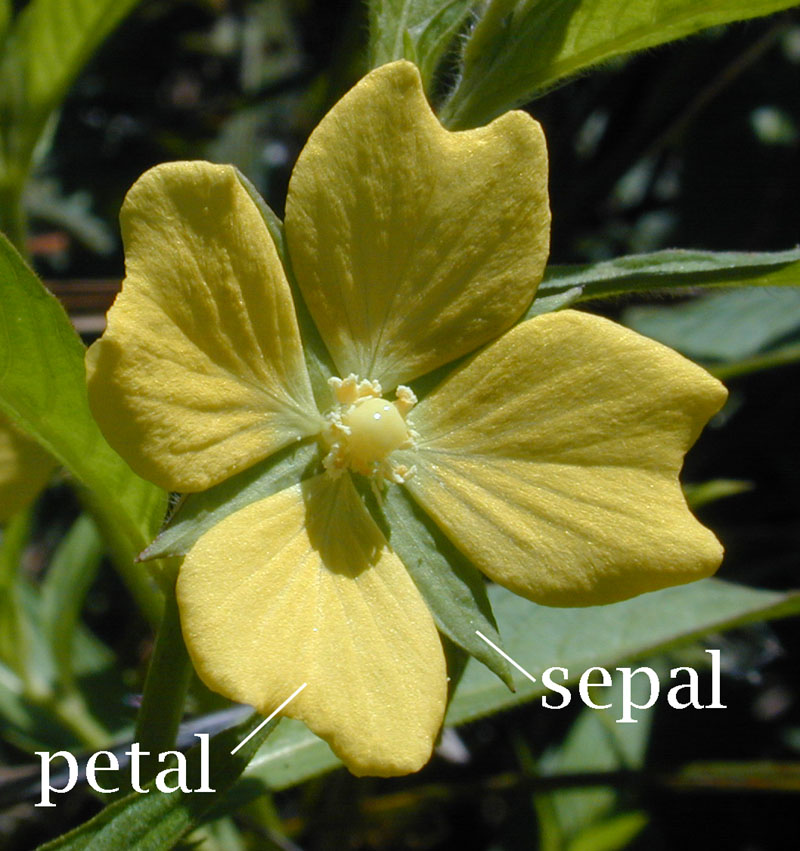
Un individu est ici une fleur.
Pour chaque individu, on mesure ses caractéristiques :
- longueur et largeur des sépales,
- longueur et largeur des pétales.
On a fait ce relever pour une centaine de fleurs et on obtient un fichier iris.csv dont voici un résumé :
| sepal_length | sepal_width | petal_length | petal_width | species |
|---|---|---|---|---|
| 5.1 | 3.5 | 1.4 | 0.2 | setosa |
| 4.9 | 3.0 | 1.4 | 0.2 | setosa |
| 4.7 | 3.2 | 1.3 | 0.2 | setosa |
| 4.6 | 3.1 | 1.5 | 0.2 | setosa |
| 5.0 | 3.6 | 1.4 | 0.2 | setosa |
| 5.4 | 3.9 | 1.7 | 0.4 | setosa |
| 4.6 | 3.4 | 1.4 | 0.3 | setosa |
| 5.0 | 3.4 | 1.5 | 0.2 | setosa |
| 4.4 | 2.9 | 1.4 | 0.2 | setosa |
| 4.9 | 3.1 | 1.5 | 0.1 | setosa |
L'unité est le centimètre.
Ce que l'IA doit faire
On présente une nouvelle fleur qui ne fait pas partie de la base de données d'entraînement. On on veut deviner son espèce.
| longueur sépale | largeur sépale | longueur pétale | largeur pétale | espèce |
|---|---|---|---|---|
| 4.3 | 2.5 | 1.1 | 0.3 | ? |
L'algorithme KNN cherchera les K plus proches fleurs dans la base d'entraînement afin de décider l'espèce de notre inconnue.
Implémentation
Lecture des données
Commencez par récupérer le fichier iris.csv
Je vous propose ensuite d'utiliser Pandas. Nous allons en profiter pour exploiter quelques-unes de ses fonctions.
import pandas

data = pandas.read_csv("iris.csv", delimiter=",")
Exécutez.
En console, vous pouvez visualiser un aperçu du contenu de data :
>>> data.head()
Pandas s'est chargé de convertir en float les données numériques. On n'a donc rien de plus à faire !
Je vous demande de le faire en console pour ne pas encombrer le programme. On pourrait faire cet affichage depuis le programme.
Visualisation
Pour bien comprendre le fonctionnement de l'algorithme, nous allons faire un graphique.
Pour que le graphique reste lisible, on va supprimer une partie des données. On se contentera des pétales et on enlèvera les sépales (juste pour cette représentation graphique)
def graphique_light(data):
    # suppression de deux colonnes. axis = 1 signifie colonne.
    data_light = data.drop(['sepal_width', 'sepal_length'], axis = 1)
    # choix de couleurs pour les différentes espèces
    colormap = { "setosa":'b', "virginica":'g', "versicolor":'k' }
    couleurs = [colormap[s] for s in data_light['species'].values.tolist()]
    # tracé
    data.plot.scatter(x = 'petal_length', y = 'petal_width', c = couleurs)
Vous pouvez voir les fleurs représentées par des points colorés.
Lecture des données
Les données sont stockées dans un fichier, une base de données. Il faut donc une fonction permettant de collecter les données et de les mettre en forme.
Exemple iris
Partant d'un fichier texte iris.csv dont voici un résumé :
sepal_length,sepal_width,petal_length,petal_width,species
5.1,3.5,1.4,0.2,setosa
4.9,3.0,1.4,0.2,setosa
4.7,3.2,1.3,0.2,setosa
4.6,3.1,1.5,0.2,setosa
5.0,3.6,1.4,0.2,setosa
5.4,3.9,1.7,0.4,setosa
...
Produire un tableau dont chaque ligne est un dictionnaire représentant un individu (une fleur)
[
    {"sepal_length":5.1, "sepal_width":3.5, "petal_length":1.4, "petal_width":0.2, "species":"setosa"},
    {"sepal_length":4.9, "sepal_width":3.0, "petal_length":1.4, "petal_width":0.2, "species":"setosa"},
    {"sepal_length":4.7, "sepal_width":3.2, "petal_length":1.3, "petal_width":0.2, "species":"setosa"},
    ...
]
Appelons get_data() cette fonction.
Calcul de distance
Entre l'individu inconnu à classifier et un des N individus du fichier de données, il faut pouvoir calculer une distance. En mathématiques il existe de nombreuses possibilités. Nous pouvons nous limiter à une distance euclidienne, c'est à dire la distance habituelle.
Appelons distance(inconnu, individu) cette fonction.
Exemple iris
Les individus ont 4 attributs sepal_length, sepal_width, petal_length, petal_width. On peut les voir comme des coordonnées $(x_1, x_2, x_3, x_4)$.
La mesure de distance entre deux jeux de coordonnées $(x_1, x_2, x_3, x_4)$ et $(x_1', x_2', x_3', x_4')$ sera :
$$d = \sqrt{(x_1-x_1')^2 + (x_2-x_2')^2 + (x_3-x_3')^2 + (x_4-x_4')^2}$$
La valeur de la distance par elle-même n'a pas forcément d'importance. Tout ce qui nous importe, c'est de classer les distances de la plus petite à la plus grande. On peut donc se contenter de calculer le carré de la distance ce qui évite de calculer la racine et ne change rien pour nos besoins.
Réglage
Dans le cas des iris, toutes les mesures sont en cm et ont la même unité. Le calcul de distance ne pose donc pas de problème. Mais est-il bien raisonnable de faire un calcul de distance avec des axes qui représentent des quantités totalement différentes, dans des unité différentes ?
Voici un exemple pour illustrer ce problème : Prenons 3 hommes.
- A mesure 1m80 et a 36 ans
- B mesure 1m85 et a 38 ans
- C mesure 1m78 et a 40 ans
entre B et C, qui est le plus proche de A ?
- si on mesure en mètres, A(1.8,36) B(1.85,38) C(1.78,40) et le calcul donne AB < AC
- si on mesure en mm, A(1800,36) B(1850,38) C(1780,40) et le calcul donne AB > AC
Cela montre qu'il faudra peut-être choisir une échelle de mesure adaptée car les données brutes peuvent conduire à surestimer, ou sous-estimer, des distances.
Trier
On sait calculer la distance $d_i$ entre l'inconnu $x$ et n'importe quel individu $i$ de nos données. On a besoin d'une fonction qui :
- calcule toutes les distances $d_i$,
- extrait les $k$ plus petites de ces distances avec les individus associés,
- renvoie la catégorie de chacun des $k$ individus ayant la plus petite distance avec $x$.
Appelons select_knn(inconnu, individus, k) cette fonction.
Exemple d'implémentation
def categorie(individu):
    '''
    fonction dépendant des choix faits dans le problème
    considéré et qui se contente de renvoyer la catégorie
    assignée à cet individu.
    '''
    # simple exemple pour les iris :
    return individu['species']

def select_knn(inconnu, individus, k):
    # création de paires (distance, categorie)
    paires = [ (distance(inconnu, individu), categorie(individu)) for individu in individus]
    # tri des paires en triant selon la distance, c'est à dire paire[0]
    paires.sort(key=lambda paire: paire[0])
    # lecture des k premiers en ne relevant que la catégorie (paire[1])
    return [paire[1] for paire in paires[:k]]
Majoritaire
On dispose d'une liste de $k$ étiquettes de catégorie. Il ne reste qu'à compter la catégorie majoritaire.
Appelons get_majoritaire(categories) cette fonction.
Tout ensemble
Toutes les fonctions étant définies, la fonction knn qui pour un individu renvoie sa catégorie serait en Python :
individus = get_data() # individus du fichier d'entraînement

def knn(inconnu, individus, k):
    categories = select_knn(inconnu, individus, k)
    m = select_majoritaire(categories)
    return m